شخصان وعشرة دولارات والمركز الثاني عالميًا: شهادة بضمير المتكلّم عن احتلال المركز الثاني بين 39 نظامًا على leaderboard عام للتعرّف على الكلام العربي (Arabic ASR)، متقدّمَين على OpenAI وGoogle وMeta وNvidia وMistral وMicrosoft، من مختبر منزلي بسيط، بلا training وبأقل من عشرة دولارات من وقت الـ GPU
للمبتدئين قراءة نحو 14 دقيقة
في 20 أكتوبر 2026 أغلق أحد القائمين على Open Universal Arabic ASR Leaderboard الـ issue الذي فتحناه على GitHub بسطر واحد: أُضيفت النتائج.[1] فتحتُ الـ leaderboard. كان نظامنا، Sygma ASR Arabic، في المركز الثاني بين 39 نظام ASR، بمتوسط WER قدره 23.01 بالمئة.[2] تحته نماذج من OpenAI وGoogle وMeta وNvidia وMistral وفريق Qwen في Alibaba وMicrosoft. وفوقه نظام واحد فقط، Jais-ASR، يتقدّم بـ0.19 نقطة.
كنّا اثنين: ابني باسل، طالب في جامعة البترا، وأنا، نعمل من مختبر منزلي بسيط. لا منحة، ولا cluster، ولا فريق. وقت الـ GPU للدراسة كلها، كل تجربة نجحت وكل تجربة فشلت، كلّف أقل من عشرة دولارات على بطاقة مستأجرة.[3] ومن أول تشغيل إلى الإدراج الرسمي مرّ أقل من أسبوعين.
وهذه هي الجملة الأهم، وأريدها في الفقرة الثانية لا الأخيرة: نحن لم ندرّب نموذجًا. لم نجمع ألف ساعة من الصوت، ولم نعمل fine-tuning لأيّ شيء انتهى به المطاف في النتيجة. أخذنا نموذجًا مفتوحًا (open weights) أصدرته Cohere في يوليو برخصة Apache، وتركنا كل weight فيه كما هو تمامًا، وغيّرنا فقط الطريقة التي يختار بها النموذج من بين الجمل التي يفكّر فيها أصلًا.[4] ذلك التغيير كان يساوي أكثر من نقطة WER، والنقطة كانت المسافة بين المركز الرابع والثاني.
هذا المقال عن سبب إمكان ذلك، وعمّا أخطأ في الطريق، وعمّا يعنيه لكل من قيل له إن الذكاء الاصطناعي صار لعبة شركات المليارات. أرويه بضمير المتكلّم لأنني كنت هناك، وبصيغة الجمع حيث كان ابني معي.
قبل عشر سنوات ما كان لهذه القصة أن تحدث. كان نظام ASR المنافس يحتاج آلاف الساعات من الصوت المفرَّغ (transcribed)، وفريقًا لتنظيفها، وأسابيع على hardware قد يملكه قسم جامعي ولا يملكه فرد. ثلاثة أشياء تغيّرت، وكل واحد منها رافعة يستطيع شخص واحد سحبها.
الـ open weights. أساس نظامنا هو Cohere Transcribe Arabic، نموذج بملياري parameter صدر في 7 يوليو 2026 بأوزانه (weights) على Hugging Face برخصة Apache-2.0.[4][5] وليس وحده. نموذج Whisper من OpenAI مفتوح منذ 2022.[6] ونماذج Meta متعددة اللغات، وQwen3-ASR من Alibaba، وVoxtral من Mistral، وعائلتا Conformer وParakeet من Nvidia، كلها قابلة للتنزيل. الجزء المكلف من العمل، الجزء الذي يحتاج البيانات والـ cluster، منتهٍ ومُهدى. وما تبقّى هو كل ما تفعله الشركة بعد الـ training، وذلك الجزء رخيص.
Benchmarks عامة بقواعد عامة. الـ leaderboard الذي دخلناه يديره مركز ELM للأبحاث وتصفه ورقة في مؤتمر Interspeech 2025.[7] يقيّم كل نموذج على ست test sets تغطي التلفزيون السعودي، وكلامًا مقروءًا من 25 لهجة جُمع من متطوعين، وصوت يوتيوب نظيفًا وصاخبًا، ونشرات الأخبار، وثماني لهجات مغاربية وشامية.[8] كود التقييم على GitHub. تقدّم نظامك بفتح issue. القائمون على الـ leaderboard يشغّلون نظامك بأنفسهم وينشرون الرقم. لا أحد يسأل أين تعمل. الحلبة نفسها، والحكم نفسه، لمشاركة من شخصين ولـGoogle.
الـ compute بالساعة. استأجرنا GPU من نوع RTX A6000 بذاكرة 48 غيغابايت بـ61 سنتًا في الساعة.[3] تمرير الـ test sets الست عبر النموذج الأساسي (base model) يستغرق نحو 25 دقيقة، والـ decoding بثمانية مرشّحين الذي نستخدمه نحو 80 دقيقة. الرصيد الابتدائي في الحساب كان 9.34 دولارًا، وكفى الدراسة.
لا سرّ في أي من هذه الروافع. البوابة في الرسم أعلاه مفتوحة والمفتاح على العشب. السؤال هو لماذا لا يعبر منها مزيد من الناس، وأظن الجواب أنهم يعتقدون أن الحركة الوحيدة التي تستحق هي الحركة المكلفة: درّب (train) شيئًا أكبر. بقية هذا المقال عن حركة مختلفة.
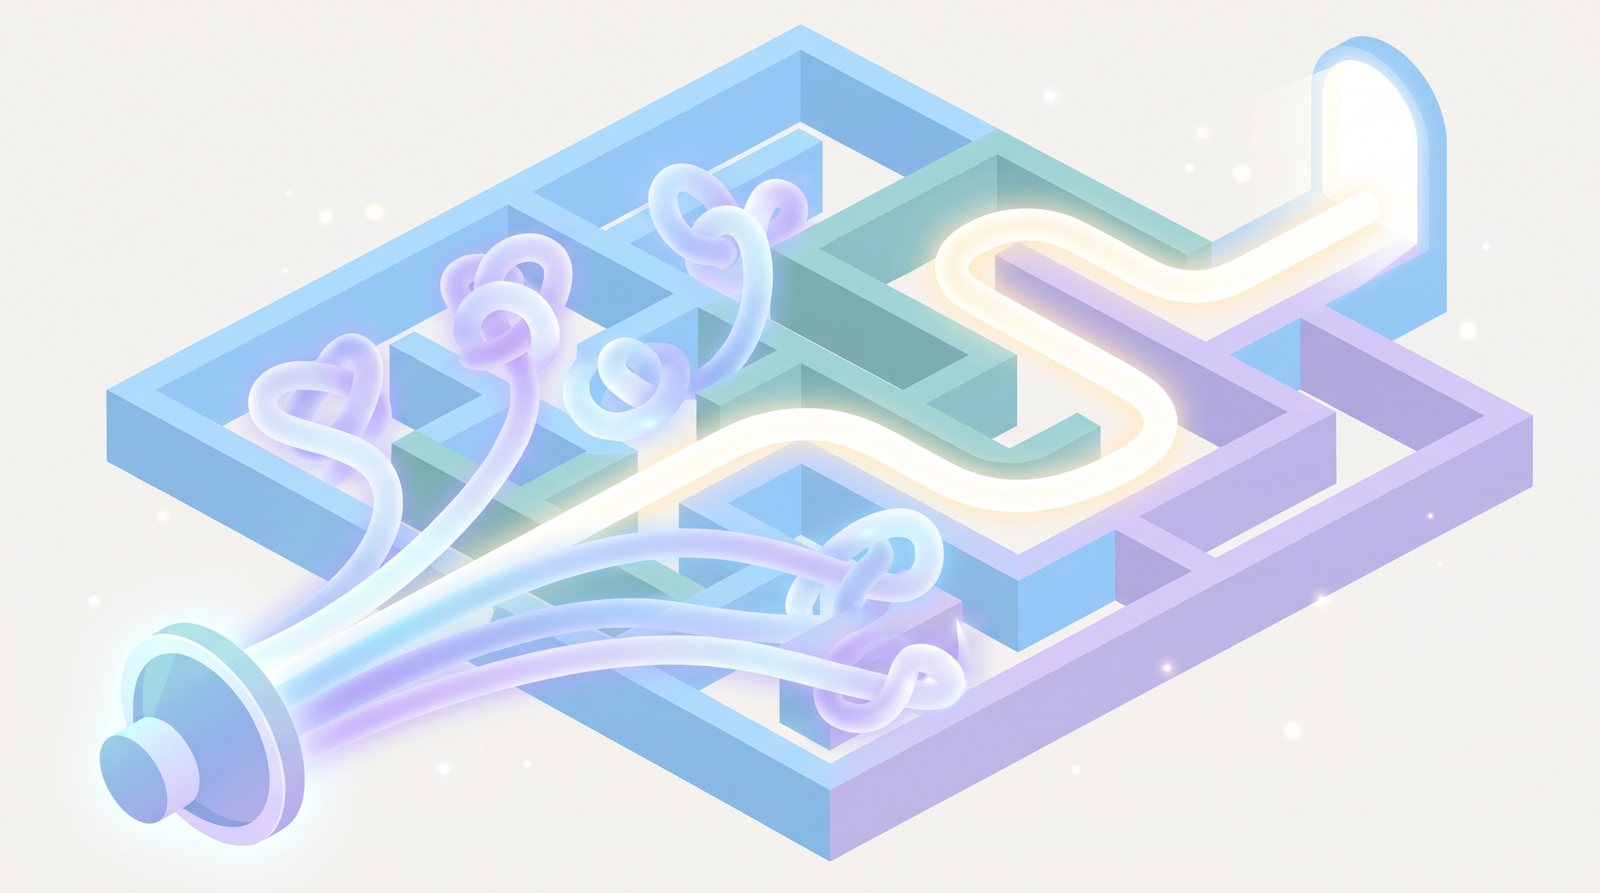
يعمل نظام ASR من هذا النوع على مرحلتين. الـ encoder يستمع إلى الصوت ويحوّله إلى سلسلة طويلة من الأرقام. ثم الـ decoder يكتب النص token بعد token، وفي كل خطوة يختار من بين احتمالات. الطريق المختصر المعتاد هو الـ greedy decoding: خذ دائمًا الـ token التالي الأرجح ولا تنظر إلى الوراء. والبديل الأشهر هو الـ beam search: أبقِ الجمل الجزئية الثماني الأرجح حيّة، ومدّد كلًّا منها، وأعد الأفضل مكتملةً في النهاية.
للـ beam search عيب معروف. الـ score الخاص بالجملة هو مجموع الـ log-probabilities لرموزها (tokens)، وكل token يضيف عددًا سالبًا، فالجمل الأطول تحصل على score أسوأ لمجرد أنها أطول. أمام جملة من ست كلمات وكلماتها الثلاث الأخيرة، كثيرًا ما يفضّل النموذج الكلمات الثلاث حتى لو سمع الست كلها. على الـ test sets ظهر هذا التفضيل على شكل deletions: الـ beam search وحده ارتكب deletions أكثر بنسبة 36 بالمئة من الـ greedy decoding، وكان في المتوسط أسوأ قليلًا.[9]
الإصلاح صغير إلى حدّ يكاد يُحرج. أضف مكافأة (reward) نقطة واحدة لكل كلمة إلى score كل مرشّح قبل الاختيار. هذا كل شيء. الجملة الطويلة التي كان النموذج قد وجدها أصلًا تفوز الآن. في مقطع حقيقي من بيانات الـ tuning، كان المرجع (reference) ست كلمات والمرشّح الأول ثلاث كلمات، فانتقل الـ WER في ذلك المقطع من 50 بالمئة إلى صفر لأن الجملة الكاملة كانت الثانية في القائمة طوال الوقت.[9] وعبر الـ benchmarks الستة أزالت المكافأة نحو 12 ألف deletion وأضافت نحو 3500 insertion، وانخفض متوسط الـ WER من 24.16 إلى 23.05 بالمئة في الـ pipeline الخاص بنا.
أضفنا قطعة ثانية أصغر: filter يرمي المرشّح حين يكون معطوبًا بوضوح، مثل كلمة تتكرر في loop حتى يصبح نصف الناتج تلك الكلمة، أو سلسلة من الشرطات السفلية. لا يحتاج الـ filter إلى نص مرجعي، وغيّر المتوسط بجزء من مئة من النقطة، لكنه كان مهمًّا لسبب آخر سأصل إليه.
طريقتنا لا تحسّن السمع. إنها تحسّن الاختيار.
أريد أن أكون واضحًا بشأن حجم هذه الفكرة. الـ length bias في الـ beam search معروف منذ سنوات، والـ length normalization هو الإصلاح المدرسي وقد اختبرناه (يساعد، لكن أقل). لن ينال أحد جائزة أفضل ورقة عن per-word reward. ما فعلناه هو أننا لاحظنا أن نموذجًا أصدره للتوّ مختبر جيد التمويل ما زال يُشحن بأبسط طرق الـ decoding، وقسنا بدقة كم كلّف ذلك على الـ benchmark العام، وأصلحناه بكود التقييم العام قبل أي أحد آخر. هذا نوع من العمل يكون الفرد أقدر عليه من الشركة، والقسم التالي يشرح لماذا.
لم تكن فكرة الـ decoding هي الخطة. الخطة، في أغسطس، كانت الحركة المكلفة: fine-tuning لنموذج Cohere على الكلام الأردني ليفهم لهجتي أنا أفضل. بنينا نموذج موافقة وweb app للتسجيل للطلاب، ونزّلنا الـ MASC dataset بحجم 82 غيغابايت، وصفّينا منها 34 ساعة من صوت يوتيوب الأردني مع الـ subtitles.
بعد ثلاثة runs كنا قد تعلّمنا ثلاثة أشياء. الـ run الأول جعل النموذج أسوأ على مقاطع الاختبار الأردنية، من 18.14 إلى 22.40 بالمئة WER. والـ run الثالث، بعد الإصلاحات، وصل إلى 17.88، وهو مقابل 18.14 ضوضاء (noise). الـ bug وراء الـ runs السيئة يستحق التدوين لأنه سيعضّ شخصًا آخر: الـ encoder يحوي طبقات BatchNorm، وتجميد أوزان الـ encoder لا يجمّد الـ running statistics الخاصة بـ BatchNorm. درّبنا والنموذج في train mode، فانجرفت الإحصاءات، وcheckpoint سجّل 11.9 في الذاكرة سجّل 17.6 بعد إعادة التحميل، لأن الـ decoder المحفوظ لم يعد يطابق الـ encoder الأصلي.[10] الدرس الثاني كان البيانات: في عيّنة فحصناها، ثلث الـ subtitles كان مخالفًا للصوت. والثالث كان القواعد: MASC إحدى test sets الـ leaderboard، فنموذج مدرَّب عليها ما كان ليُقبل على أي حال.[8]
جرّبنا فكرتين أخريين تبدوان مكلفتين ولم تعطِ أيّ منهما شيئًا. language model من نوع 4-gram مدرَّب على 23 مليون جملة نجدية اختار وزنًا صفريًّا عند الـ tuning: المرشّحون الثمانية يختلفون غالبًا في الإملاء والترقيم، وهذا ما لا يستطيع word-level language model الحكم فيه. والـ rescoring بـ neural language model صغير، Qwen3-1.7B، رفع benchmark وخفض آخر وحصيلته صفر.[10]
ثم هناك الادعاء الذي سحبناه. في البداية بدا أن نظامنا يتفوّق على المتصدّر آنذاك، Audar، على الكلام السعودي بفارق واسع. لم يكن كذلك. مخرجات Audar الخام احتوت نحو أربعين مقطعًا سقط فيها الـ decoder في loop، يكرّر عبارة حتى يبلغ الـ length limit، وكلّفته تلك المقاطع الأربعون 7.6 نقطة WER على ذلك الـ test set. حين منحنا مخرجات Audar الـ breakdown filter نفسه الذي منحناه لمخرجاتنا، انخفض متوسطه من 26.37 إلى 24.05 وصار أفضل منا بوضوح على الكلام السعودي النظيف.[9] صحّحنا سجلّ التجارب، وأعدنا كتابة المقارنة، وذكرنا الرقمين. هذا ما كان الـ filter لأجله حقًّا: لا للفوز، بل للمقارنة العادلة.
وأخطأت أشياء أصغر أيضًا. بناءُ language model نفدت ذاكرته (out of memory) عند 62 غيغابايت. وسكربت tuning وزَن مجموعة من ثمانية مقاطع بوزن مجموعة من ستمئة. وglob للملفات تجاوز ملفين بصمت. وGPU بقي خاملًا ساعة في انتظار marker لن يظهر. أسرد هذا لأن النتيجة النهائية تبدو حتمية في صفّ على leaderboard، ولم تكن كذلك.
الجدول الرسمي كما قُرئ في 3 نوفمبر 2026 أدناه للأنظمة الأربعة الأولى والـ base model الذي بنينا عليه. الأقل أفضل؛ المقياس هو الـ WER بالمئة. الصفّ المظلّل هو صفّنا.[2]
| System | SADA | Common Voice | MASC clean | MASC noisy | MGB-2 | Casablanca | Average |
|---|---|---|---|---|---|---|---|
| 1. IFM Jais-ASR | 30.52 | 8.59 | 16.14 | 25.47 | 9.60 | 46.61 | 22.82 |
| 2. Sygma ASR Arabic (ours) | 33.63 | 5.24 | 15.92 | 25.10 | 13.48 | 44.67 | 23.01 |
| 3. Audar-ASR-V1-Turbo | 28.92 | 8.09 | 16.73 | 27.19 | 11.08 | 47.02 | 23.17 |
| 4. Cohere Transcribe Arabic (base) | 36.83 | 5.27 | 16.35 | 25.65 | 15.33 | 45.68 | 24.19 |
القيم الرسمية للوحة Open Universal Arabic ASR Leaderboard كما قُرئت في 3 نوفمبر 2026. الخط الغامق يعلّم أقل WER على كل test set بين الأنظمة الـ39 كلها. صفّ Cohere هو الـ base model من دون تغيير وبالـ decoding الافتراضي.
ثلاث قراءات صادقة لذلك الجدول. أولًا، نظامنا يملك أقل WER بين الأنظمة الـ39 كلها على مجموعتين من الست، Common Voice وCasablanca، وأقل CER على Casablanca أيضًا. وعلى MASC clean وMASC noisy هو الثاني، خلف نموذج أقدم من Cohere أضعف بكثير على الـ test sets الأربع الأخرى. ثانيًا، هو ليس الأفضل على الكلام السعودي: Audar يتفوّق علينا هناك بنحو خمس نقاط، وJais-ASR يتفوّق علينا على نشرات الأخبار بنحو أربع. طريقتنا شحذت الاختيار؛ ولم تغيّر ما يستطيع النموذج سماعه. ثالثًا، الفارق عن المركز الأول 0.19 نقطة، وقد أُضيف Jais-ASR إلى الـ leaderboard في 18 أكتوبر، بعد تسعة أيام من تقديمنا وقبل يوم من ظهور صفّنا. لو حُدّث الـ leaderboard يوم قدّمنا لكنّا الأوائل طوال تلك الأيام التسعة. الترتيب على leaderboard حيّ طقسٌ لا مناخ.
الشكل الثاني هو ما كنت سأعرضه على متشكّك. إنه الـ base model من دون تغيير، بالـ decoding الافتراضي وبالـ decoding الخاص بنا، على كل من الـ test sets الست، في الـ pipeline الخاص بنا حيث الـ runs متطابقة إلا في الـ decoding. المكسب على كل test set. وهو الأكبر على كلام التلفزيون السعودي ونشرات الأخبار، حيث كانت الكلمات المحذوفة.
لدى Cohere مهندسون ممتازون. والـ length bias موجود في كل كتاب مدرسي. فلماذا وصلت مشاركة من شخصين إلى إصلاحه على الـ leaderboard العام؟
الحوافز. المختبر يُكافأ على شحن النماذج. منشور إطلاقه يقول «أدقّ نموذج عربي مفتوح المصدر» وينتقل إلى الـ training run التالي.[4] patch في الـ decoding يكسب نقطة لا يصنع منشور إطلاق. أما بالنسبة إلينا فالنقطة كانت المشروع كله.
الانتباه هو المورد النادر، لا الـ compute. الشيء الوحيد الذي امتلكنا منه أكثر من أي شركة هو الاستعداد للتحديق في 45,845 transcript من نصوص الاختبار والسؤال: لماذا يُسقط النموذج كلمات؟ السؤال لا يكلّف شيئًا. أخذ من أب وابنه عطلة نهاية أسبوع. لا أحد في مختبر مكلَّف به، لأن تجهيز أدوات تشغيل الـ benchmark العام من أوله إلى آخره عملُ يوم كامل أصلًا، والمكافأة المتوقعة هامشٌ في ورقة.
الحلبة عامة وتكافئ هذا بالضبط. إرشادات الـ leaderboard نفسها تقول إنها ترحّب بالمشاركات التي تأتي بـ architecture غير موجودة على الـ leaderboard وتتجنّب الـ training على الـ test datasets.[8] هذه قاعدة كُتبت لمن لا يستطيع شراء طريقه إلى الأعلى بـ in-domain data. ضبطنا رقمًا واحدًا على 608 مقاطع من خارج كل الـ benchmarks وقلنا ذلك. القائمون على الـ leaderboard تحقّقوا، وشغّلوا الكود، ونشروا النتيجة في أحد عشر يومًا.
الـ open weights تنقل الحدود إلى الأطراف. ما إن يصبح النموذج عامًّا حتى تنتهي ميزة المختبر عند ملف الـ weights. وكل ما بعده، الـ decoding، والـ filtering، والـ chunking، والـ evaluation، والإبلاغ الصادق، هندسةٌ يستطيع شخص واحد حريص أداءها كما يؤدّيها مئة. بل أذهب أبعد: مئة شخص في شركة سيؤدّونها أسوأ، لأن لا أحد منهم يملك الـ pipeline كله كما ملكناه نحن.
جرّد القصة من أرقامها وما يتبقّى شيئان لا يكلّف استئجارهما شيئًا لأنهما لا يُستأجران أصلًا: الفهم لكيفية عمل الآلة فعلًا، والإبداع في استخدام ذلك الفهم في اتجاه لم يكن أحد ينظر إليه.
الفهم جاء أولًا، ولم يكن من النوع البرّاق. كان علينا أن نعرف أن الـ decoder يقيّم الجملة بجمع أعداد سالبة، واحد لكل token، وأن هذه الحسبة وحدها تعاقب الطول. وأن نعرف أن الـ beam search يحتفظ بثمانية مرشّحين ويرمي سبعة، فقد تكون الإجابة الصحيحة جالسة في القائمة بلا استخدام. وأن نعرف لماذا يمكن لـ encoder مجمّد أن يتغيّر أثناء الـ training، لأن BatchNorm يحتفظ بإحصاءات ليست weights. لا شيء من هذا متقدّم. كله من النوع الذي يتعلّمه الطالب في مساق وينساه قبل الامتحان، لأنه لا يبدو مهمًّا أبدًا. هنا كان اللعبة كلها: كل نتيجة من نتائجنا، الإيجابية والسلبية، تنبع من حقيقة في كتاب مدرسي أُخذت على محمل الجد.
الإبداع كان النصف الثاني، وبدا أقرب إلى إذن منه إلى إلهام. الإذن بأن نعامل نموذجًا أصدره مختبر جيد التمويل على أنه غير مكتمل. الإذن بطرح سؤال ساذج، «لماذا يُسقط النموذج كلمات؟»، والإجابة عنه بقراءة المرشّحين بدل تدريب شيء ما. الإذن بإنفاق الميزانية على النظر لا على الـ compute. المكافأة نفسها، نقطة لكل كلمة، تكاد تكون فكرة مضحكة. الفعل الإبداعي لم يكن اختراعها؛ بل ملاحظة أن الإصلاحات المكلفة التي يمدّ الجميع أيديهم إليها، بيانات أكثر، language model، نموذج أكبر، كانت الأدوات الخطأ لمشكلة اختيار، وأن الأداة الصحيحة طولها سطر واحد.
الاثنان يعتمد أحدهما على الآخر. من دون الفهم تصبح الحركة الإبداعية تخمينًا، وما كنا لنعرف لماذا جعل الـ beam search وحده الأمور أسوأ أو لماذا لم تستطع الـ language models المساعدة. ومن دون الإبداع يبقى الفهم في دفاتر المحاضرات. الشركة تملك الاثنين بوفرة، موزّعَين على مئة شخص. ما تملكه نادرًا هو الاثنان في الرأس نفسه في الوقت نفسه، موجّهَين نحو مشكلة صغيرة بما يكفي لتُحلّ في عطلة نهاية أسبوع. تلك هي الميزة الوحيدة التي يملكها شخص في مختبر منزلي، وهي الوحيدة التي تهمّ.
الـ compute يُستأجر بالساعة. الفهم لا يُستأجر، والإبداع ليست له قائمة أسعار.
ما يلي ليس نصيحة قرأتها في مكان ما. إنه قائمة الأشياء التي فعلناها فعلًا، بالترتيب الذي كان سيوفّر علينا الوقت.
التكلفة الإجمالية للخطوات الثماني: أقل من عشرة دولارات من إيجار الـ GPU، وlaptop-ان في مختبر منزلي، ونحو أسبوعين كان الأب فيهما يدرّس أيضًا والابن يدرس أيضًا.
لا يعني أن غرفة نوم تستطيع إنتاج foundation model. الـ encoder ذو الملياري parameter الذي يقوم بالاستماع درّبته Cohere على بيانات وhardware لن نراهما أبدًا، ودولاراتنا العشرة تجلس فوق ذلك الاستثمار. الصورة الصحيحة ليست داود وجالوت. إنها ميكانيكي عدّل سيارة شحنها المصنع، وتغلّب على سائق المصنع نفسه على حلبة عامة.
ولا يعني أن الترتيب سيصمد. ظهر Jais-ASR قبل صفّنا بيوم واحتلّ المركز الأول. وقد قال القائمون على الـ leaderboard إنهم ينظّفون الـ test sets ويضيفون length limit موحّدًا لكل نموذج، وهذا سيحرّك عدة صفوف.[1] إن كنت تحتاج أن يكون رقمك دائمًا فلا تضعه على leaderboard حيّ.
ولا يعني أن حيل الـ decoding تكفي. على الكلام السعودي سقفُ طريقتنا مرئي: نموذج مدرَّب على بيانات سعودية أكثر يتفوّق علينا بخمس نقاط WER، ولا قدر من الـ re-ranking يسدّ ذلك. الاختيار لا يستطيع اختراع ما لم يسمعه الـ encoder.
ولا يعني أنه كان سهلًا. معظم الطاولة كان فشلًا. والشيء الذي نجح كان صغيرًا، ولم يبدُ بديهيًّا إلا بعد ذلك.
طوال معظم تاريخ هذا المجال كان الجواب عن سؤال «هل يستطيع شخص واحد أن ينافس؟» هو لا، لأن الموردين النادرين كانا البيانات والـ compute وكلاهما مملوك. في 2026 المورد النادر مختلف. إنه الاستعداد لأخذ نموذج مفتوح وbenchmark عام وGPU مستأجر، والنظر بعناية إلى حيث يفشل النموذج، وتغيير شيء واحد، والإبلاغ عن النتيجة مع إخفاقاتها مرفقة. الشركات سيئة بنيويًّا في ذلك الجزء الأخير. والأفراد يمكن أن يكونوا جيدين جدًّا فيه.
المركز الثاني بين 39 ليس بيت القصيد، وحين تقرأ هذا قد يكون الرقم مختلفًا. بيت القصيد هو الصفّ فوق صفّنا والصفوف تحته. فوقه: فريق واحد درّب نموذجه بنفسه. وتحته: أفضل أنظمة الكلام من أغنى شركات الأرض، كل واحد منها هُزم على benchmark عربي عام بتغيير في الـ decoding يكلّف صفحة من الكود. البوابة مفتوحة. والمفتاح على العشب.
أعجبك المقال؟تابع الصفحة لمقالات جديدة في الذكاء الاصطناعي وأخبار الفضاء اليومية.
تابعنا على فيسبوكجميع الروابط اطُّلع عليها في 3 نوفمبر 2026. قيم الـ leaderboard كما عُرضت في ذلك التاريخ؛ وهو يُحدَّث باستمرار. الرسوم مولَّدة بواسطة Google Gemini لهذا المقال.